最小二乗法はデータから函数を近似する最も基本的な統計手法である。 応答函数 \(Y\) (統計学の慣例に従い、確率的な変数を大文字で書く。)が独立変数(回帰変数) \(X\) との関係が線型であるとき、
\[
\mathbf{Y} = \mathbf{X}\boldsymbol\beta + \boldsymbol\epsilon
\]
と表すことができる。 ここで、 \(\mathbf{Y} = (Y_1\,Y_2\,\dots\,Y_N)^\mathrm{T}\) は \(N\times 1\) の行列、
\(\mathbf{X} = (\mathbf{1}_N\,\mathbf{x}_1\,\mathbf{x}_2)\) は \(N\times (p + 1)\) の回帰行列、 \(\mathbf{x}_i\) は \(p \times 1\) の \(i\) 番目の独立変数のベクトル、 \(\boldsymbol\beta = (\beta_0\,\beta_1\,\dots\,\beta_p)^\mathrm{T}\) は \((p + 1) \times 1\) の回帰係数のベクトル、 \(\boldsymbol\epsilon = (\epsilon_1\,\epsilon_2\,\dots\,\epsilon_N)^\mathrm{T}\) は \(N \times 1\) のランダム誤差ベクトル、 \(\mathbf{1}_N = (1\,1\,\dots\,)^\mathrm{T}\) は要素が \(1\) のベクトルを表す。
\(\mathbf{X}\) に多重共線性があるとは、 \(\mathbf{X}^\mathrm{T}\mathbf{X}\) が特異に近く、 \(\mathbf{X}^\mathrm{T}\mathbf{X}\) の固有値の中に \(0\) に近いものがあることを示す。 正則化項を付加したリッジ回帰は、多重共線性を回避するために用いられる。
\(\mathbf{Y}\) の観測データ \(\mathbf{y} = (y_1\,y_2\,\dots\,y_N)^\mathrm{T}\) が得られたとする。
\[
\mathbf{y} = \mathbf{X}\boldsymbol\beta + \mathbf{e}
\]
ここで \(\mathbf{e}\) は残差ベクトルである。
\(\boldsymbol\beta\) の推定値 \(\hat{\boldsymbol\beta} = (\hat{\beta}_0\,\hat{\beta}_1\,\dots\,\hat{\beta}_p) \in \mathbb{R}^{p+1}\) は、最小二乗函数
\[
S(\boldsymbol\beta) = \mathbf{e}^\mathrm{T}\mathbf{e} = (\mathbf{y} - \mathbf{X}\boldsymbol\beta)^\mathrm{T}(\mathbf{y} - \mathbf{X}\boldsymbol\beta)
\]
を最小化することにより得られる。 その解は正規方程式
\[
\mathbf{X}^\mathrm{T}\mathbf{X}\hat{\boldsymbol\beta} = \mathbf{X}^\mathrm{T}\mathbf{y}
\]
により与えられる。
\(\mathbf{y}\) の予測値は
\[
\hat{\mathbf{y}} = (\hat{\mathbf{y}}_1\,\hat{\mathbf{y}}_2\,\dots\,\hat{\mathbf{y}}_N)^\mathrm{T} = \mathbf{X}\hat{\boldsymbol\beta}
\]
となる。
\(\hat{\mathbf{e}} = (\hat{e}_1\,\hat{e}_2\,\dots\,\hat{e}_N)^\mathrm{T} = \mathbf{y} - \hat{\mathbf{y}}\) は残差であり、平均二乗誤差平方根は
\[
\mathrm{RMSE} = \sqrt{\frac{\hat{\mathbf{e}}^\mathrm{T}\hat{\mathbf{e}}}{N}}
\]
で与えられる。
最小二乗法による予測は
\[
f(x) = \hat{\beta}_0 + \sum_{j=1}^p \hat{\beta}_j x_j
\]
で与えられる。 ここで、 \(f:\,\mathbb{R}^p \rightarrow \mathbb{R}\) 、\(\mathbf{x} = (x_1\,x_2\,\dots\,x_p)^\mathrm{T}\in\mathbb{R}^p\) である。
最小二乗法の欠点は、外れ値に敏感であることである。 外れ値に対する敏感性を回避するために考案されたのが、ロバスト回帰でM推定とも呼ばれる。
ロバストカーネルリッジ回帰
Wibowo (2009 ) は、カーネルリッジ回帰とM推定を組み合わせた手法 ロバストカーネルリッジ回帰(R-KRR: robust kernel ridge regression)を考案した。
特徴量空間における回帰
特徴量マップ
\[
\psi: \mathbb{R}^p \rightarrow \mathcal{F}\in\mathbb{R}^{p_\mathcal{F}}\;p_\mathcal{F} > p
\]
を考える。 ここで \(\mathcal{F}\) は特徴量空間を表す。
特徴量行列
\[
\boldsymbol\Psi = (\psi(x_1)\,\psi(x_2)\,\dots\,\psi(x_N))^\mathrm{T}
\]
の積
\[
\mathbf{K} = \boldsymbol\Psi\boldsymbol\Psi^\mathrm{T}
\]
をカーネル行列という。
\[
\sum_{i=1}^N \psi(\mathbf{x}_i) = 0
\]
を仮定する。
標準中心化された特徴量空間での多重線型回帰は次のように書ける。
\[
\mathbf{Y}_\mathrm{o} = \boldsymbol\Psi\boldsymbol\gamma + \tilde{\boldsymbol\epsilon}
\]
ここで、 \(\boldsymbol\gamma = (\gamma_1\,\gamma_2\,\dots\gamma_{p_\mathcal{F}})^\mathrm{T}\) と \(\tilde{\boldsymbol\epsilon}\) は、それぞれ特徴量空間における回帰係数ベクトルとランダム誤差を表す。
\[
\mathbf{Y}_\mathrm{o} = \left(\mathbf{I}_N - \frac{1}{N}\mathbf{1}_N\mathbf{1}_N^\mathrm{T}\right)\mathbf{Y}
\]
は偏差である。
\(\mathbf{Y}_\mathrm{o}\) の観測値
\[
\mathbf{y}_\mathrm{o} = (y_{\mathrm{o}1}\,y_{\mathrm{o}2}\,\dots\,y_{\mathrm{o}N})^\mathrm{T}\in\mathbb{R}^N
\]
に対する回帰
\[
\mathbf{y}_\mathrm{o} = \boldsymbol\Psi\boldsymbol\gamma + \tilde{\mathbf{e}}
\]
を考える。
\(\tilde{\mathbf{e}} = (\tilde{e}_1\,\tilde{e}_2\,\dots\,\tilde{e}_N)\in\mathbb{R}^N\) は残差ベクトルである。
\(\boldsymbol\Psi\) は未知なので、\(\boldsymbol\gamma\) は一般化逆行列を解くことで求めることはできない。
リッジ回帰は
\[
(\mathbf{y}_\mathrm{o} - \boldsymbol{\Psi\gamma})^\mathrm{T}(\mathbf{y}_\mathrm{o} - \boldsymbol{\Psi\gamma}) + \tilde{q}\boldsymbol\gamma^\mathrm{T}\boldsymbol\gamma
= \sum_{i = 1}^N(y_{\mathrm{o}i} - \psi(\mathbf{x}))^2 + \tilde{q}\boldsymbol\gamma^\mathrm{T}\boldsymbol\gamma
\]
を最小化する最適化問題を解く。
ロバスト回帰
M推定では
\[
\sum_{i = 1}^N\rho(y_{\mathrm{o}i} - \psi(\mathbf{x}))^2 + \tilde{q}\boldsymbol\gamma^\mathrm{T}\boldsymbol\gamma
\tag{1}\]
を最小化する。
\(\rho\) が満たすべき要件は次の通りである。
対称: \(\rho(e_i) = \rho(-e_i)\)
正: \(\rho(e_i) > 0\)
単調増加: $(|e_i|) > (|e_j|), |e_i| > |e_j| $
\(\mathbb{R}\) 上で下に凸。
最小二乗法では、 \(\rho(z) = z^2\) である。
次のHuber函数は、よく使われる。
\[
\rho(z) = \begin{cases} \frac{1}{2}z^2 & |z| \le k\\ k|z| - \frac{1}{2}k^2 & |z| > k
\end{cases}
\]
\(\partial\) (Equation 1 )\(/\partial\gamma_j\) より
\[
-\sum_{i = 1}^N \tilde{w}_i\tilde{e}_i\psi(\mathbf{x}_i)^\mathrm{T} + 2\tilde{q}\boldsymbol\gamma^\mathrm{T} = \mathbf{0}^\mathrm{T}
\]
ここで
\[
\tilde{w}(z) = \begin{cases}
\rho'(z)/z & z \ne 0 \\
1 & z =0
\end{cases}
\]
重み函数、 \(\tilde{w}_i = \tilde{w}(\tilde{e}_i)\) である。 \(\tilde{e}_i = y_{\mathrm{o}i} - \psi(\mathbf{x}_i)^\mathrm{T}\boldsymbol\gamma\) を用いると
\[
\sum_{i = 1}^N \tilde{w}_i y_{\mathrm{o}i} \psi(\mathbf{x}_i)^\mathrm{T} =
\sum_{i = 1}^N \tilde{w}_i \psi(\mathbf{x}_i)^\mathrm{T} \boldsymbol\gamma \psi(\mathbf{x}_i)^\mathrm{T} + 2\tilde{q}\boldsymbol\gamma^\mathrm{T} = \mathbf{0}^\mathrm{T}
\]
と書ける。行列で表すと
\[
(\boldsymbol\Psi^\mathrm{T}\tilde{\mathbf{W}}\boldsymbol\Psi + 2\tilde{q}\mathbf{I}_{p_\mathcal{F}})\boldsymbol\gamma = \boldsymbol\Psi^\mathrm{T}\tilde{\mathbf{W}}\mathbf{y}_\mathrm{o}
\]
\(\boldsymbol\theta = \tilde{W}^{1/2}\boldsymbol\Psi\) , \(\mathbf{z}_\mathrm{o} = \tilde{\mathbf{W}}^{1/2}\mathbf{y}_\mathrm{o}\) と置くと
\[
\tilde{\boldsymbol\gamma}(\tilde{q}) = (\boldsymbol\theta^\mathrm{T}\boldsymbol\theta + 2\tilde{q}\mathbf{I}_{p_\mathcal{F}})^{-1}\boldsymbol\theta^\mathrm{T}\mathbf{z}_\mathrm{o}
\]
と書ける。
Push-through(通り抜け)恒等式
\[
(\mathbf{I} + \mathbf{UV})^{-1}\mathbf{U} = \mathbf{U}(\mathbf{I} + \mathbf{VU})^{-1}
\]
を用いると
\[
(\boldsymbol\theta^\mathrm{T}\boldsymbol\theta + 2\tilde{q}\mathbf{I}_{p_\mathcal{F}})^{-1}\boldsymbol\theta^\mathrm{T}\mathbf{z}_\mathrm{o} =
\boldsymbol\theta^\mathrm{T}(\boldsymbol{\theta\theta}^\mathrm{T} + 2\tilde{q}\mathbf{I}_N)^{-1}\mathbf{z}_\mathrm{o}
\]
と書けるので、
\[
\tilde{\boldsymbol\gamma}(\tilde{q}) = \boldsymbol\theta^\mathrm{T}(\boldsymbol{\theta\theta}^\mathrm{T} + 2\tilde{q}\mathbf{I}_N)^{-1}\mathbf{z}_\mathrm{o} =
\boldsymbol\Psi^\mathrm{T}\tilde{\mathbf{W}}^{1/2}(\tilde{\mathbf{W}}^{1/2}\mathbf{K}\tilde{\mathbf{W}}^{1/2} + 2\tilde{q}\mathbf{I}_N)^{-1}\tilde{\mathbf{W}}^{1/2}\mathbf{y}_\mathrm{o}
\]
カーネルトリック
Mercerの定理によると、対称な連続正定値カーネル \(\mathbf{K}: \mathbb{R}^p\times\mathbb{R}^p\rightarrow\mathbb{R}\) を選べば、 \(\kappa(\mathbf{x}_i,\,\mathbf{x}_j) = \phi^\mathrm{T}(\mathbf{x}_i)^\mathrm{T}\phi(\mathbf{x}_j)\) なる \(\phi: \mathbb{R}^p\rightarrow\mathcal{F}\) が存在し、
\[
\mathbf{K} = \begin{pmatrix}
K_{11} & K_{12} & \dots & K_{1N}\\
K_{21} & K_{22} & \dots & K_{2N}\\
\vdots & \vdots & \ddots & \vdots\\
K_{N1} & K_{N2} & \dots & K_{NN}
\end{pmatrix}
\]
により \(\mathbf{K}\) の具体的な形が得られる。 無限を含む高次の \(p_\mathcal{F}\) に写像する \(\phi\) を明示的に知らなくても、有限のデータからカーネルが得られる。 これをカーネルトリックという。
\(\mathbf{y}\) の予測値は次の式から求められる。
\[
\tilde{\mathbf{y}} = \bar{\mathbf{y}}\mathbf{1}_N + \boldsymbol\Psi\tilde{\boldsymbol\gamma}(\tilde{q}) = \bar{\mathbf{y}}\mathbf{1}_N +
\boldsymbol\Psi^\mathrm{T}\tilde{\mathbf{W}}^{1/2}(\tilde{\mathbf{W}}^{1/2}\mathbf{K}\tilde{\mathbf{W}}^{1/2} + 2\tilde{q}\mathbf{I}_N)^{-1}\tilde{\mathbf{W}}^{1/2}\mathbf{y}_\mathrm{o}
\]
ここで、\(\bar{y} = \mathbf{1}_N^\mathrm{T}\mathbf{y}\) は観測の平均で \(\hat{\tilde{\mathbf{e}}} = \mathbf{y} - \hat{\mathbf{y}}\) は残差である。
\(\boldsymbol\Psi\) は未知なので \(\boldsymbol\gamma\) を推定するのに、反復重み付き最小二乗法は直接使うことはできないので、 \(\tilde{\mathbf{y}}\) を反復して求める。 \(\tilde{\mathbf{y}}\) は \(\tilde{\mathbf{w}}\) に、 \(\tilde{\mathbf{w}}\) は \(\tilde{\mathbf{e}}\) に、 \(\tilde{\mathbf{e}}\) は \(\tilde{\mathbf{y}}\) に依存している。
R-KRR
R-KRRの手順をまとめると次の通りである。
\(p\) 個の特徴量からなる \(N\) 組のデータ \((y_i, x_{i1}, x_{i2}, \dots, x_{ip})\, i = 1, 2, \dots N\) が与えられたとする。平均 \(\bar{y} = \mathbf{1}_N^\mathrm{T}\mathbf{y}\) と偏差 \(\mathbf{Y}_\mathrm{o} = \left(\mathbf{I}_N - \frac{1}{N}\mathbf{1}_N\mathbf{1}_N^\mathrm{T}\right)\mathbf{Y}\) を計算する。
カーネル \(\kappa:\,\mathbb{R}^p \times \mathbb{R}^p \rightarrow \mathbb{R}\) 、ノルム \(\rho:\,\mathbb{R} \rightarrow \mathbb{R}\) 、リッジ定数 \(\tilde{q} > 0\) を選択する。
\(K_{ij} = \kappa(\mathbf{x}_i,\,\mathbf{x}_j), \mathbf{K} = (K_{ij})\) を構築する。\(\mathbf{y}\) の予測を行う。収束するまで bとcを繰り返す。
\(\mathbf{y}\) の第一推定値 \(\tilde{\mathbf{y}}^{(0)}\) を与える。各反復回 \(t\) 毎に残差と重みを計算する。 \(\hat{\tilde{\mathbf{e}}}^{(t - 1)} = \mathbf{y} - \tilde{\mathbf{y}}^{(t - 1)},
\tilde{\mathbf{w}}^{(t-1)} = \tilde{\mathbf{w}}(\hat{\tilde{\mathbf{e}}}_i)\)
予測値を更新する。 \(\tilde{\mathbf{y}}^{(t)} = \bar{\mathbf{y}}\mathbf{1}_N +
\mathbf{K}\tilde{\mathbf{W}}_{(t-1)}^{1/2}(\tilde{\mathbf{W}}_{(t-1)}^{1/2}\mathbf{K}\tilde{\mathbf{W}}_{(t-1)}^{1/2} + 2\tilde{q}\mathbf{I}_N)^{-1}\tilde{\mathbf{W}}_{(t-1)}^{1/2}\mathbf{y}_\mathrm{o}\)
\(\mathbf{c} = (c_1\,c_2\,\dots\,c_N)^\mathrm{T}) = \tilde{\mathbf{W}}_{(\hat{t}-1)}^{1/2}(\tilde{\mathbf{W}}_{(\hat{t}-1)}^{1/2}\mathbf{K}\tilde{\mathbf{W}}_{(\hat{t}-1)}^{1/2} + 2\tilde{q}\mathbf{I}_N)^{-1}\tilde{\mathbf{W}}_{(\hat{t}-1)}^{1/2}\mathbf{y}_\mathrm{o}\) を計算する。\(\mathbf{x}\in\mathbb{R}^p\) が与えられたとき、予測値は \(g(\mathbf{x}) = \bar{\mathbf{y}} + \sum_{j=1}^N c_i K(\mathbf{x}, x_j)\) で計算できる。
計算例
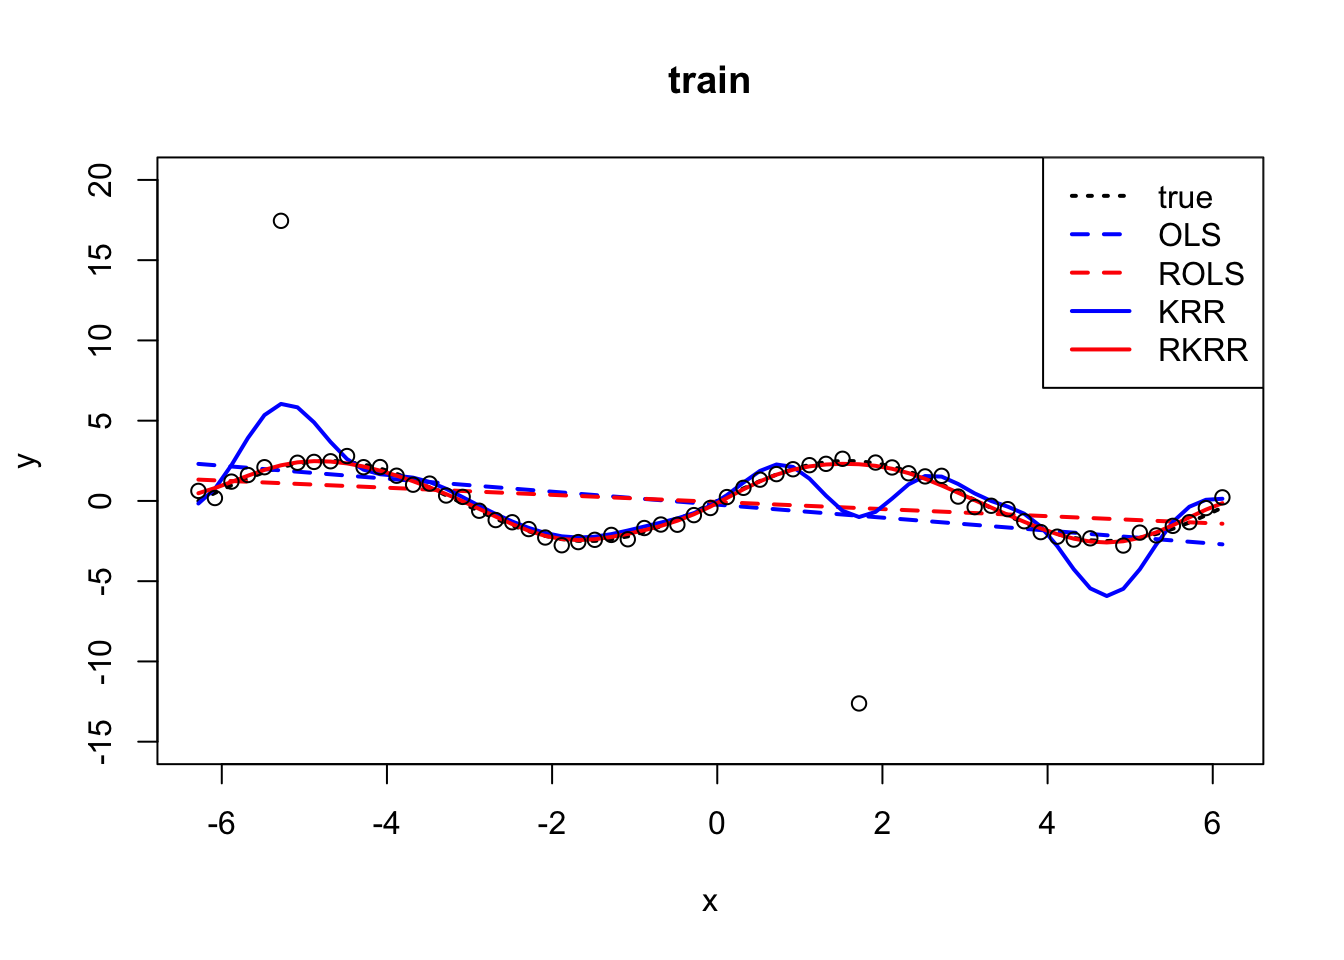
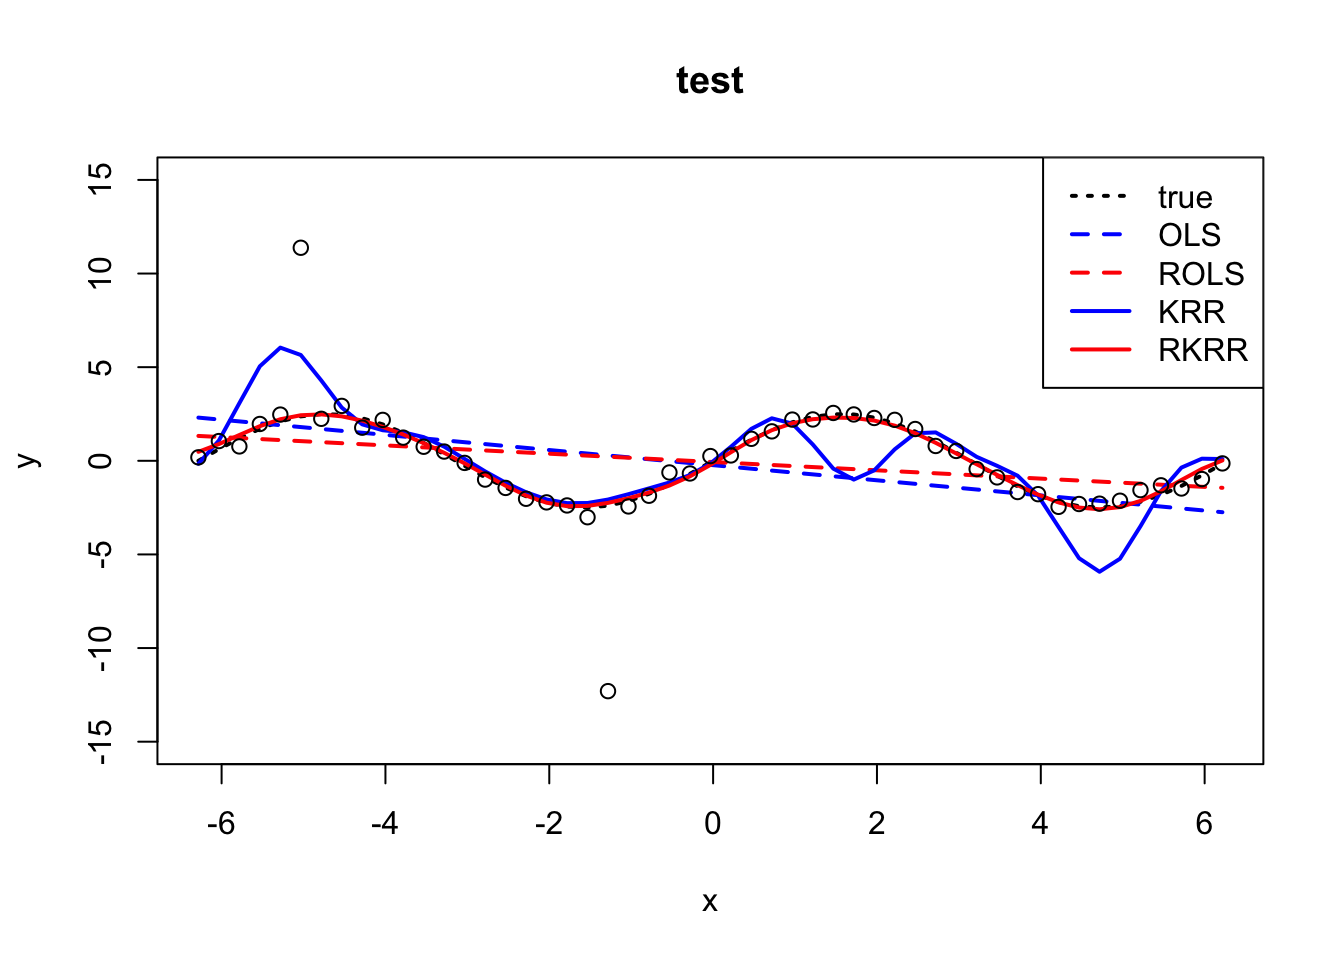
Wibowo (2009 ) の例で線型回帰(OLS)、ロバスト線型回帰(ROLS)、カーネルリッジ回帰(KRR)ロバストカーネル回帰(RKRR)を比較する。
Code
<- function (x, y, rho) {<- outer (x, y, "-" )^ 2 exp (- r2 / rho)<- function (x) {2.5 * sin (x)<- function (model, x_test) {rbf_kernel (x_test, x_train, model$ rho) %*% model$ c0<- function (e, k = 1.345 ) {# Meidan absolute deviation <- median (abs (e - median (e))) / 0.6745 if (s < 1e-5 ) s <- 1e-5 <- e / s<- rep (1 , length (e))<- abs (e_scaled) > k<- k / abs (e_scaled[outliers])<- function (x_train, y_train,q = 0.1 , rho = 1 , max_iter = 50 , tol = 1e-5 ) {<- length (x_train)<- mean (y_train)<- y_train - y_bar<- rbf_kernel (x_train, x_train, rho)<- diag (n) # n x n identity matrix <- w_sqrt %*% kmat %*% w_sqrt + 2 * q * diag (n)<- w_sqrt %*% solve (mmat, w_sqrt %*% y_o)<- c<- y_bar + kmat %*% c # Kenel ridge regression for (t in 1 : max_iter) {<- y_pred<- y_train - y_pred<- huber_weight (e)<- diag (sqrt (w))<- w_sqrt %*% kmat %*% w_sqrt + 2 * q * diag (n)<- w_sqrt %*% solve (mmat, w_sqrt %*% y_o)<- y_bar + kmat %*% cif (max (abs (y_pred - y_pred_old)) < tol) {cat ("R-KRR IRLS converged at iteration" , t, " \n " )break if (t == max_iter) cat ("Warning: R-KRR IRLS reached max_iter without full convergence. \n " )list (x_train = x_train, y_bar = y_bar, c0 = c0, c = c, rho = rho, w = w)<- function (model, x_test) {<- rbf_kernel (x_test, model$ x_train, model$ rho)$ y_bar + kmat %*% model$ c<- function (x_train, y_train, max_iter = 50 , tol = 1e-5 ) {<- length (x_train)<- cbind (1 , x_train)<- solve (t (X) %*% X, t (X) %*% y_train)<- beta # Save standard OLS coefficients <- X %*% betafor (t in 1 : max_iter) {<- y_pred<- y_train - y_pred<- huber_weight (e)<- diag (w)<- solve (t (X) %*% W %*% X, t (X) %*% W %*% y_train)<- X %*% betaif (max (abs (y_pred - y_pred_old)) < tol) {cat ("R-OLS IRLS converged at iteration" , t, " \n " )break if (t == max_iter) cat ("Warning: R-OLS IRLS reached max_iter without full convergence. \n " )list (beta0 = beta0, beta = beta)<- function (model, x_test) {<- cbind (1 , x_test)%*% model$ beta0<- function (model, x_test) {<- cbind (1 , x_test)%*% model$ beta<- 514 set.seed (seed)<- 0.2 <- 63 <- 1 : n_train - 1 <- - 2 * pi + 0.2 * loc_train<- rnorm (n_train, 0 , s_train)<- f (x_train) + e_train6 ] <- y_train[6 ] + 15 41 ] <- y_train[41 ] - 15 56 ] <- y_train[56 ] - 15 <- 0.25 <- 51 <- 1 : n_test - 1 <- - 2 * pi + 0.25 * loc_test<- rnorm (n_test, 0 , s_test)<- f (x_test) + e_test6 ] <- y_test[6 ] + 9 21 ] <- y_test[21 ] - 10 <- rols_train (x_train, y_train)
R-OLS IRLS converged at iteration 5
Code
<- rkrr_train (x_train, y_train)
R-KRR IRLS converged at iteration 15
Code
<- ols_predict (rols, x_train)<- rols_predict (rols, x_train)<- krr_predict (rkrr, x_train)<- rkrr_predict (rkrr, x_train)<- ols_predict (rols, x_test)<- rols_predict (rols, x_test)<- krr_predict (rkrr, x_test)<- rkrr_predict (rkrr, x_test)plot (x_train, f (x_train), type = 'l' , col = 'black' ,lwd = 2 , lty = 3 ,xlab = "x" , ylab = "y" , ylim = c (- 15 , 20 ),main = "train" )lines (x_train, y_train_ols, col = 'blue' , lty = 2 , lwd = 2 )lines (x_train, y_train_rols, col = 'red' , lty = 2 , lwd = 2 )lines (x_train, y_train_krr, col = 'blue' , lty = 1 , lwd = 2 )lines (x_train, y_train_rkrr, col = 'red' , lty = 1 , lwd = 2 )points (x_train, y_train)legend ("topright" , legend = c ("true" , "OLS" , "ROLS" , "KRR" , "RKRR" ),col = c ("black" , "blue" , "red" , "blue" , "red" ),lwd = 2 , lty = c (3 , 2 , 2 , 1 , 1 ))
Code
plot (x_test, f (x_test), type = 'l' , col = 'black' ,lwd = 2 , lty = 3 ,xlab = "x" , ylab = "y" , ylim = c (- 15 , 15 ),main = "test" )lines (x_test, y_test_ols, col = 'blue' , lty = 2 , lwd = 2 )lines (x_test, y_test_rols, col = 'red' , lty = 2 , lwd = 2 )lines (x_test, y_test_krr, col = 'blue' , lty = 1 , lwd = 2 )lines (x_test, y_test_rkrr, col = 'red' , lty = 1 , lwd = 2 )points (x_test, y_test)legend ("topright" , legend = c ("true" , "OLS" , "ROLS" , "KRR" , "RKRR" ),col = c ("black" , "blue" , "red" , "blue" , "red" ),lwd = 2 , lty = c (3 , 2 , 2 , 1 , 1 ))